Naukri Market Data Scraper
Web Automation • Data Extraction
Naukri Market Telemetry Scraper
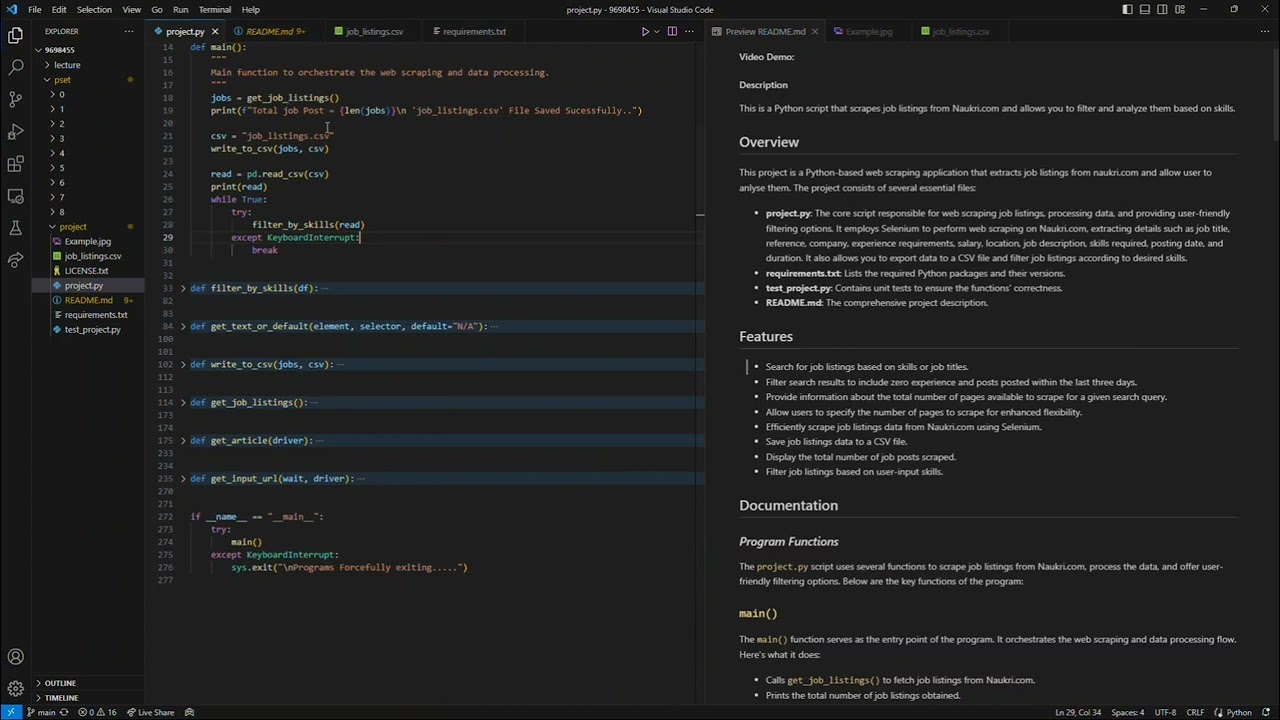
Resilient Automation: Extracts paginated job market telemetry (titles, salary bands, required skills, locations) with graceful fallback handling and pytest test benches.
Architecture & Scraping Flow
graph TD
    A["Target Search Query (Skills, Location, Experience)"] --> B["Headless Selenium Session Initialization"]
    B --> C["Explicit Polling with WebDriverWait"]
    C --> D["DOM Extraction & Fallback Normalization ('get_text_or_default')"]
    D --> E["Pandas Multi-Criterion Skill Filtering"]
    E --> F["Structured CSV Telemetry Output"]
Executive Overview
Naukri Market Data Scraper is a Python automation tool that extracts job listings from Naukri.com to facilitate programmatic tech hiring telemetry, salary benchmarking, and skill requirement analysis.
The scraper automates browser navigation across paginated listings, resolves asynchronously hydrated DOM components, normalizes inconsistent compensation notations, and filters results against user-defined skill matrices before exporting clean datasets for downstream analytics.
Technical Challenges & Architectural Solutions
1. Dynamic Client-Side Content Hydration
- Challenge: Target pages use asynchronous client-side JavaScript, causing standard static HTTP scrapers to fail due to DOM race conditions.
- Solution: Implemented explicit polling utilizing Selenium's
WebDriverWaitand expected conditions, ensuring DOM elements are fully hydrated prior to traversal.
2. Inconsistent DOM Schema Normalization
- Challenge: Varied markup across sponsored, promoted, and standard job card templates frequently resulted in
NoSuchElementExceptioncrashes. - Solution: Built fault-tolerant fallback parser helpers (
get_text_or_default) that normalize missing fields to default values without halting the extraction pipeline.
3. Automated Regression Testing
- Challenge: Ensuring scraper parser logic remains resilient against minor frontend updates.
- Solution: Authored a complete test suite in
test_project.pyusingpytest, featuring mocked DOM responses and fixture-driven parser validation.
Verified Accreditation
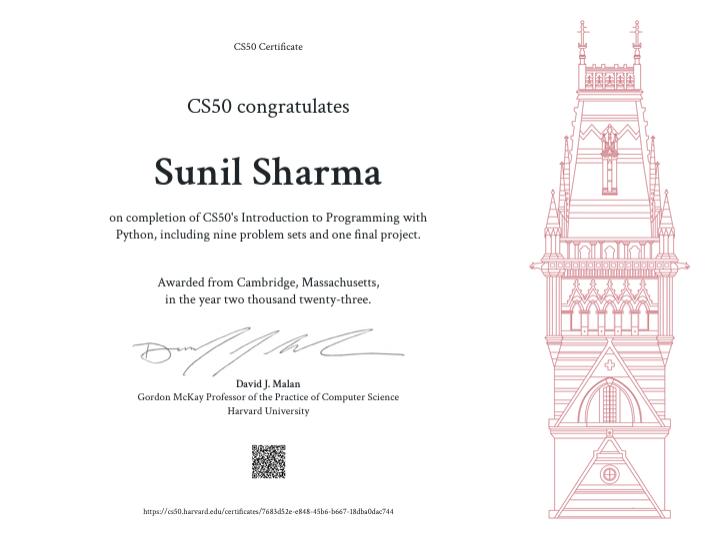
Harvard CS50P: Introduction to Programming with Python • Harvard University (CS50)
Video Demonstration